複天一流:どんな手を使ってでも問題解決を図るブログ

宮本武蔵の五輪書の教えに従い、どんな手を使ってでも問題解決を図るブログです(特に、科学、数学、工学の問題についてですが)

Honda Connect ディスプレイのOSが(勝手に)アップデートされた

以前の記事で取り上げた"Honda Connectディスプレイ"とそのデータ接続サブスクリプションサービス(Honda Connect)であるが、依然として私はこのサブスクリプションには加入していない。

これまで何不自由なく「カーナビとして最低限の機能」を利用することができていたのだが、最近GoogleかHondaかのどちらかは知らないが、「勝手にシステムを遠隔でアップデート」したようで、そのあおりを受けて、カーナビ機能が全く使えなくなってしまったのだ。

カーナビの画面が真っ黒になったその日は「これは困ったな」と当惑したのであるが、数日経過すると「昔のように頭に地図を入れてから運転するのは、意外に快適かも」と感じ始め、しまいには(壮大な無駄なかもしれない)そのディスプレイに時計を表示させて運転するのが、むしろ気分的に楽になってしまったのである。こういうのを「デジタルデトックス」というのだろうか(笑)。

しかし、家族のメンバーの多くが、「カーナビが映らない車は運転できない!」とか、「F1で醜態を曝すHONDAにはもう我慢できない!Civicは売りっぱらってドイツ車に買い換える!」などと反乱が起きたのである。あるものはホンダ本社に苦情の電話をかけたらしいが、受付業務の派遣社員の方がそんな対応できるわけがない。「システムの責任者を出せ!」などと叫いたとしても、おそらくは「システム更新の管轄はGoogleさんなので、わたくしどもにはとんとわかりませぬ」という返事が返ってくるだけだ。

怒りの矛先が私に向かってこないうちになんとかする必要性が生じ、「仕方ない。設定をいじって何とか地図を表示させないとな...」ということになり、先ほどかちゃかちゃいじってみたのである。とはいえ、Google built-inの地図は、カーナビとしては「本当に使えない」代物である。見栄えはいいのだが、運転中にその表示を示されても、運転経路をアシストするという観点から見ると、まったくの役立たずなのである!そもそも、細い道の幾何がまったく読み取れない!(下の図)
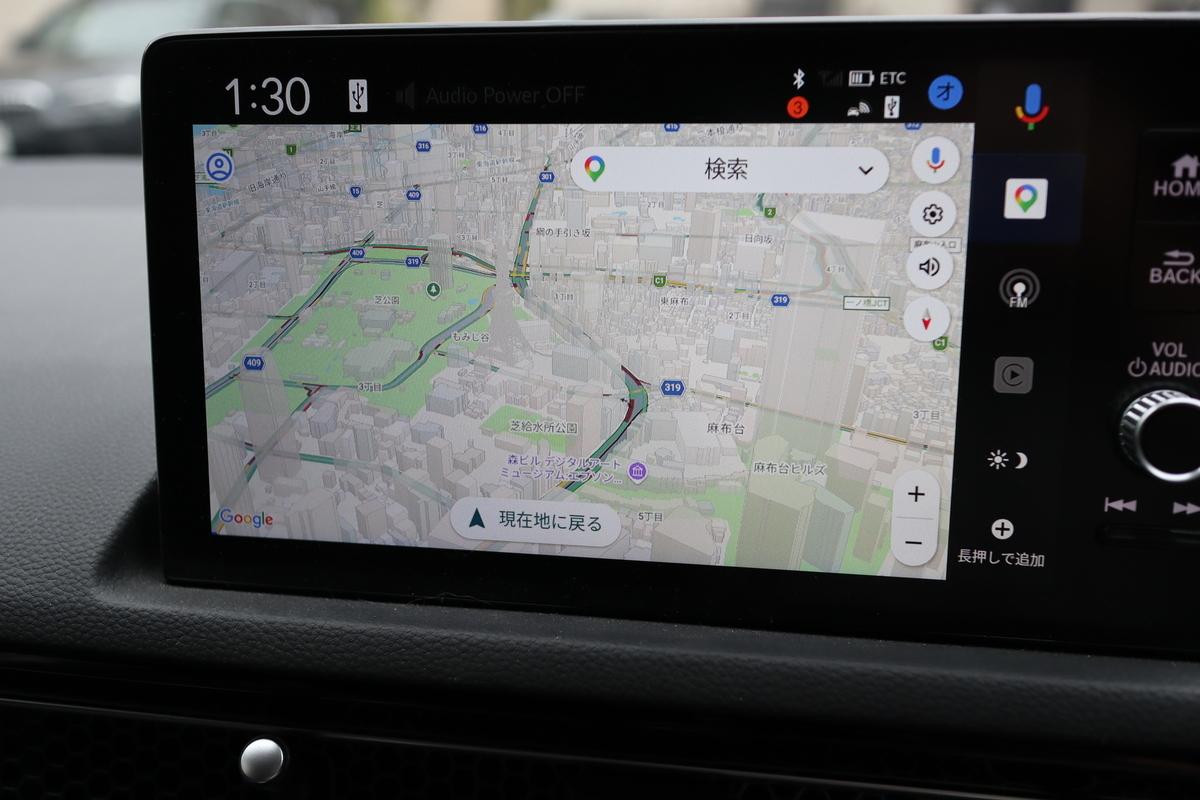
Google built-inの地図表示:芝公園周辺

CIVICは「空飛ぶ車」じゃないんだから、こんな3D表示を見せられても、芝公園や大門周辺をこれで迷わずに走るのは無理である!(ホンダ君、君はこんなんで野田岩のうなぎを食べに行けるのか?、あるいはブルースリーを増上寺まで連れて行けるのか?、是非考えてほしい笑)
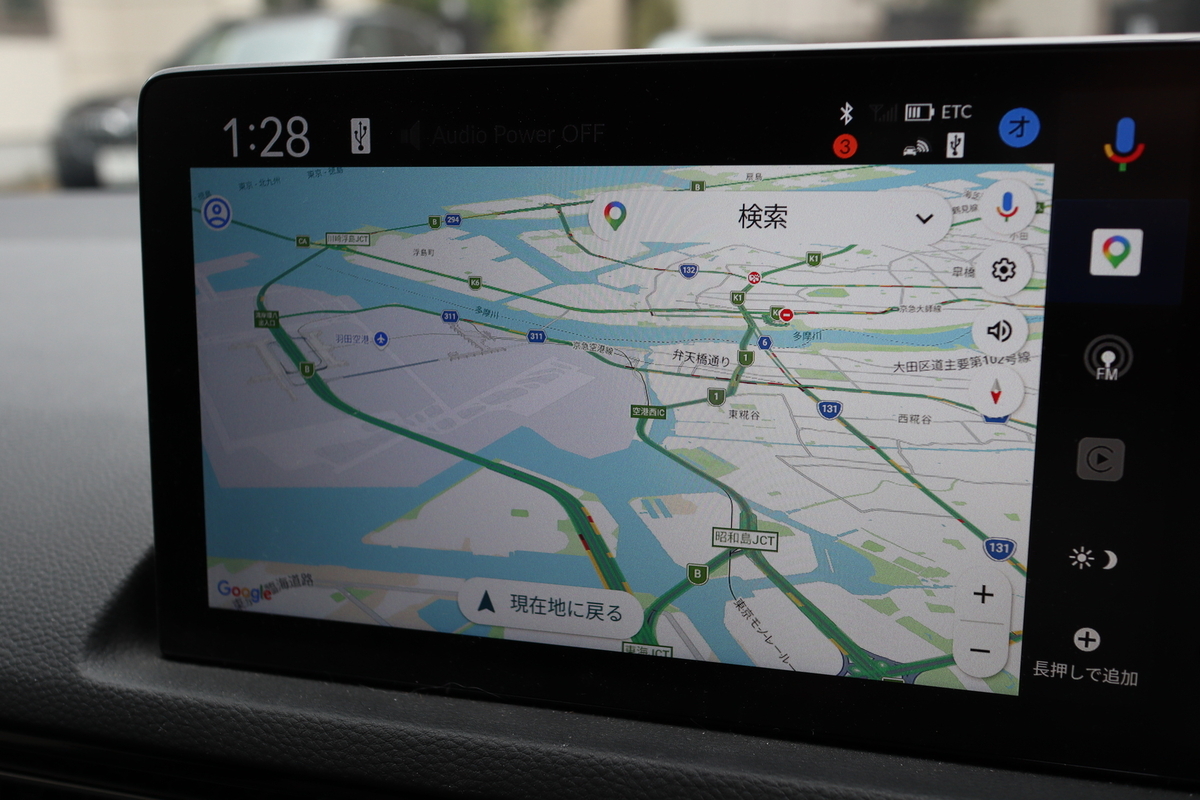
おまけ:この地図があれば私でも羽田空港に着陸できそうな気分になるから不思議である(笑)
なにはともあれ、反乱軍を鎮圧すべく、初めてHONDA ConnectのOSをかちゃかちゃといじってみたのである。その甲斐あって、30分後には何とか地図を表示させることに成功し、アップデート前の状態にまで戻すことができた。

おそらく同じような苦しみに困っておられる方も多いだろう、と感じたので、アップデートにまつわる「Honda Connect/Google built-inのカーナビブラックアウト問題」の解決法を以下に報告したいと思う(笑)。

所有者の同意なく勝手にアップデートしてしまうHonda ConnectのOS

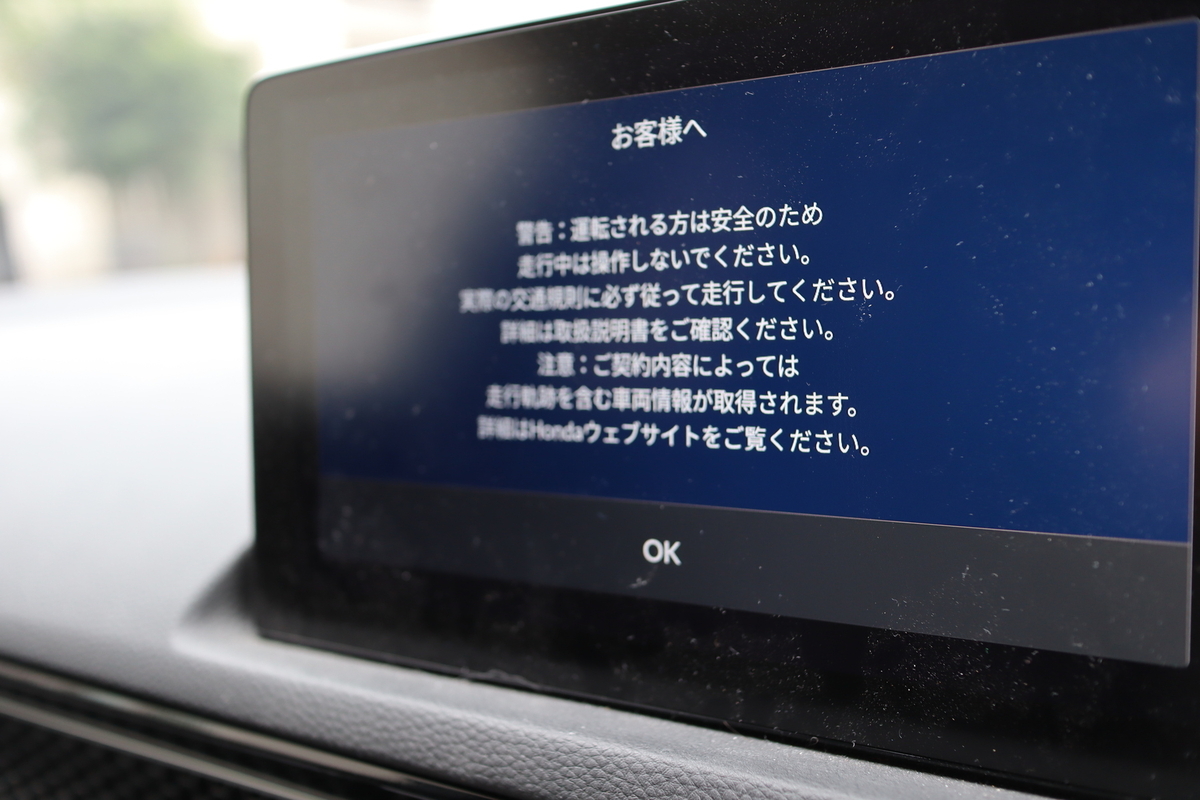
このシステムのOSはGoogle Built-inというらしいが、その日本語の翻訳が「Google搭載」という固有名詞っぽくない固有名詞となっていて紛らわしいので注意が必要だ(笑)。それはさておき、このOSは、何らかの通信手段を通じてHondaあるいはGoogleのサーバーと(私の許可なく)常時接続しているらしく、時折アップデートを勝手にやるは知っていた。

これまでのアップデートでは特に問題がなかったので、「まあよしとするか」程度だったのだが、先週行われたアップデート(所有者の許可なく勝手にやったやつ!)には大きな不満を感じた。上述のカーナビ表示のブラックアウトである!しかも、システムリセットによるオフラインマップデータの消失がその元凶と知ると、怒りのボルテージは最高潮に達した。画面に現れるエラーメッセージに「オフラインのマップデータが存在しません」と表示されたのだ。つまり、「何時間かけてダウンロードしたと思ってるんだ!勝手に消すな!」と怒り心頭なのである。

ホンダのHPを見ると、次の「お知らせ」が載っていた。

www.honda.co.jp

「随分前の記事だな」と最初思ったのだが、よく読むと、実はこのアップデートはWiFi回線を使ってのみ可能だということであった。私のCivicは普段WiFi回線でネットにはつながっていない(だからオフラインマップデータをダウンロードしてあるわけなんだが)。したがって、いくら「勝手にアップデート」といっても、WiFiがなければできないはずで、この「お知らせ」の内容と今回のブラックアウト問題は無関係のようだ。おそらくこれは(勝手なアップデートではなく)ディーラーが手作業でやってくれるサービスなんだろうと思う(私のディーラーからは連絡が全く来てないが)。

しかも私のシステムに不具合が出たのは6月ではなく、今月(つまり9月)だ。よって、この通知にあるアップデートとは無関係っぽい。想像するに、WiFiでのアップデートをサボっている消費者に「強制的な部分アップデート」をかけたのではないかと思うのだ。こういうのはたいていがHonda Connectに非加入の人たちが中心のはずだから、最新のアップデートで「もてなす」のではなく、(文句が出ない程度に)必要最低限のアップデートに絞っているのではないか、と思ったのである。さらに、いろいろと嫌がらせをかけて、最終的には「やっぱりHonda Connectに加入しますよ」というふうに仕向けたいのではないか、と感じた次第である。実際、「地図が映らないより、Honda Connectの利用料を払ってサービスを享受した方がいい」という声も我が家には響いたのであった(笑)。

しかし、今回のアップデートでは、googleが走行履歴のデータを存分に盗ませていただきます、という契約文書が表示された。ついに堂々と個人情報を取りに来たのかと、これも怒であった。不便だからといって、それに負けてはならない。負け戦の日本人のようであるが「貧しきに耐えてこそ清い精神」である(笑)。

Google built-in OSの詳細

今回初めて、システムの詳細というものを調べてみた。車は運転してなんぼ、のものなので、じっくりとディスプレイの設定画面をいじってみたことがなかったのだ。したがって、今回の「ブラックアウト問題」を契機に色々と学ぶことができたので、それはそれで収穫であった。

まず、以前からHONDA Connectがどうやって通信を外部とやりとりしているのか、という疑問が(ほぼ)解決した点である。まずはOSの設定に表示された情報をご覧いただきたい。
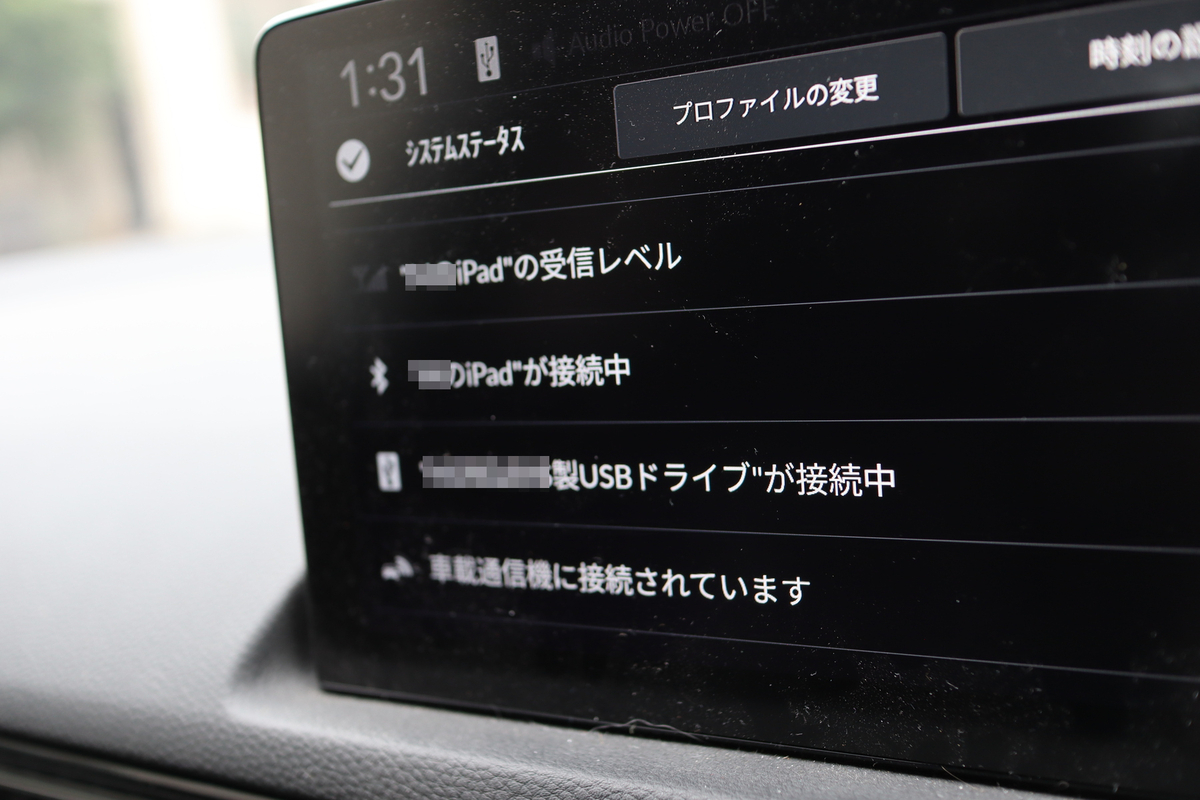
System statusの表示

車のシステムに接続されている通信回線のリストである。私の場合4つの項目があり、上の二つがiPadへの接続状態についての情報となっている。2つ目はBluetooth接続が確立しているかであり、現在確立していることがわかる。その下の「USBドライブが接続中」というのは、mp3ファイルを書き込んだSDカードをType-Cスロットに差し込んでいる、という意味である。カーステレオで聞いている音楽のソースである。

写真に写るリストの一番下にある「車載通信機」というのがかなり怪しい(データのアップデートや交通情報を勝手にやりとりしているという意味で)。これはおそらくETCのことであるが、もしかするとHonda connectで利用されるSoftBankの5G/4G回線も含まれているのかもしれない。

最後に一番上の情報が「Bluetooth接続したiPadがWiFi回線とつながっているかどうか」を示すもので、現在その強度は(アイコンをみると)ほぼゼロ状態である。つまりWiFiとは断線状態である。これは当然で、私がiPadの「テザリング」を切っているからである。テザリングというのは、iPadが接続しているWiFi回線を、Civicの車内LANにフォワードするサービス/システムのことである。私はこの車を購入した時、ディーラーからこの「テザリング」によるネット接続を勧められた。しかし、自前のWiMAXを車に直接接続することが可能であることが後でわかり、それをやることでオフラインマップのデータを折に応じてダウンロードできるようになったのである。要するに(WiMAXを持っている人の場合)テザリングは「不要」であるが、HONDAとしてはiPadを経由した「テザリング」でネットに接続してほしい、と考えているようである。おそらく6月のOSアップデートのデータも、ディーラーはテザリングによって実行するはずである。

ということで、「勝手なアップデート」は「車載通信機」がもつ何らかの機能を使って実施されていることが推察される。もし、ETCだけだとすると、私の自宅は高速道路から遠く離れているので、勝手なアップデートは不可能のはずである。にもかかわらず「勝手なアップデート」がなされてしまったということは、車載通信機には4G/5Gの電話回線への接続機能があるということになる。そもそもHONDA Connectをサブスクライブすれば、この機能を(有料で)利用するわけだから、無料データの送信条件をHondaあるいはGoogleの方で勝手に設定できるとすれば、電話回線を彼らの必要に応じて(勝手に)開き、私の車に、無断で、かつ私に求められていないデータを押し付けてくることが可能なのであろう。

別の画面に映ったシステム情報も見てみよう。
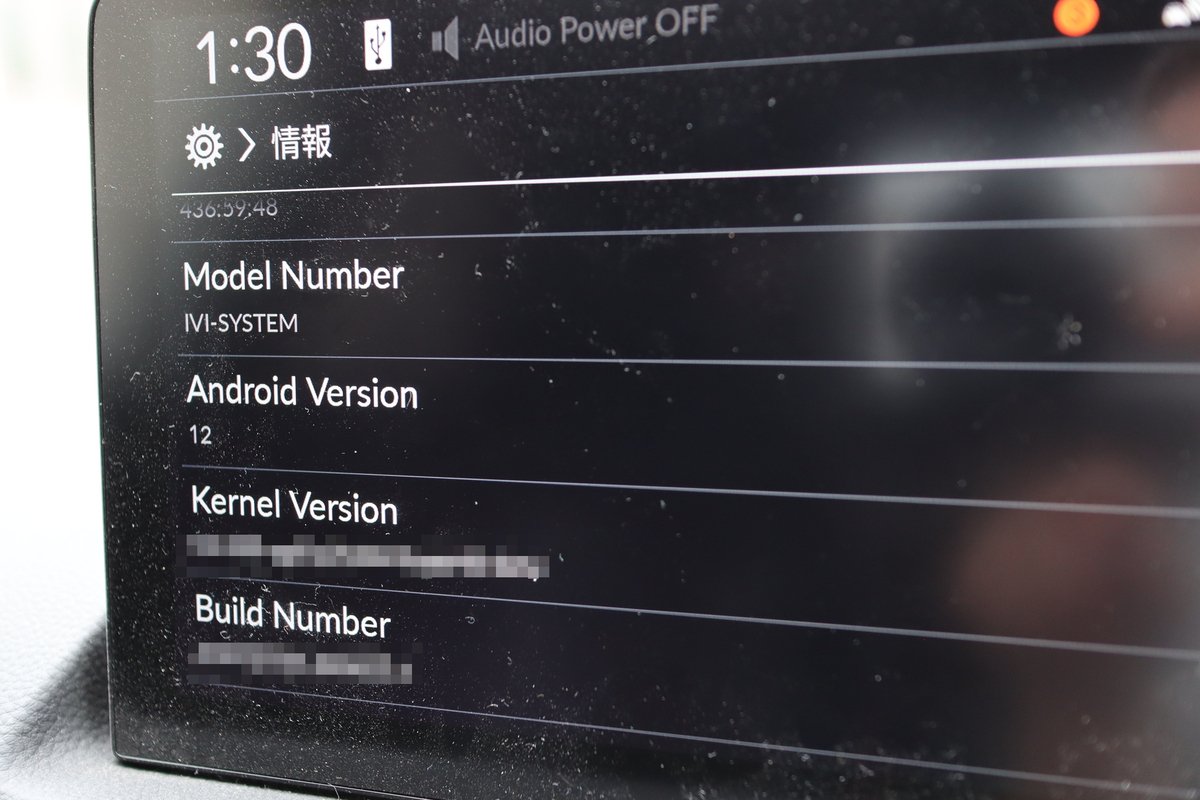
OSに関するシステム情報

上から2つ目にAndroidと出ているのが特徴出来だろう。言わずと知れたGoogleのスマートフォンで利用されているOSである。バージョンは12とあり、今年の6月に発表されたアップデートで導入されたバージョン14より古い数字となっている。WiFiに繋いでないし、私がOSのアップデートを積極的に考えていないので当然といえば当然であるが、今回の強制アップロードでは、OSのバージョンアップは実施されない、という私の予想は当たっていたことになる。かなりマイナー、しかしバグに近いエッセンシャルなバグフィックスだけが強制的に行われたと思われる。そして、さらにHonda Connectに加入したくなるような「嫌がらせ」設定に変更したというのも(高い確率で)あり得ると思われる。

一番上にModel Number: IVI-systemとあるが、調べてみるとこれはAndroid Automobile OS (AAOS)に含まれる機能で、In-Vehicle Infotainmentというシステムだという。つまり、Google built-inによるOSの正式名称はAAOSだということである。写真に写るリストの下段2つは、AAOSのカーネル番号やビルトナンバーなどであり、OS自体の根幹部分の情報と思われる。

これだけの状況証拠を知れば、(Honda Connect未加入者には本来提供されないはずの)渋滞交通情報が最近表示されるようになったり、ダウンロードしてない地域のマップデータが利用できるようになって、「へんだな」と感じていたのが、Google/Hondaの勝手な設定変更と勝手な遠隔操作による、「システム設定の変更」によるものであると説明できる。しかも、その通信回線は(以前予想していたVICSのFM電波ではなく)SoftBankの4G/5G回線である可能性が高まってきた!

ブラックアウトからの復旧方法

寄り道が過ぎた。本題に戻ろう。勝手なアップデートにより、カーナビがブラックアウトした状態からの復旧方法である。問題の原因がわかれば、笑ってしまうような内容であるが、わからない段階では、地図が映らないと相当なストレスがかかる(人が多いはず)。

原因はnoteにて記述することにした(AIに盗まれると嫌な気分がする...)。私がこの車を買った際に、「オフラインマップデータをダウンロードして利用する」と決意したが、有効期限が1年あるので、1年に1度だけ数時間かけてダウンロードすればいいのだ。そのときは確かに面倒だが、無料だし、この頻度ならなんとか耐えられるだろう。そもそも、ダウンロード中にどこかにドライブに行って仕舞えばいいのだ。東京から出発すれば、箱根や那須高原に着く頃にはダウンロードは終わっているだろう。

ということで、問題が解決するまでの大雑把な手順を以下に示す。

  1. まずは起動直後である。

起動直後の画面

この後、オーナーにログインする。しかし、私はこの「オーナー」アカウントにGoogleアカウントを紐づけてはいない。googleアカウントにログインせずに、オーナーボタンをただ選ぶだけである。多分、車体番号などのIDが車載通信機からSoftBankの回線に送信され、購入者が特定され、結局はGPSに基づく(わたしの)ドライブ情報がgoogleやhonda, softbankなどに提供されてしまうのであろう。Googleアカウントを紐づけておけば、OSにさまざまなアプリがダウンロードできるらしいし、youtubeなども閲覧できるかもしれないが、車内でそれをやる意味はないだろう(笑)。車はドライブしてなんぼ、なので、わざわざ集中力がなくなるようなシステムは不要である(というよりも命に関わる危険性がある)。そして、なにより、ドライブ情報という個人情報が大手IT企業に搾取されてしまうのだ。

それよりなにより、車を運転する際に、エンジン起動後、わざわざタッチスクリーンでパスワードを打つという面倒な作業をやりたいと思うだろうか?Googleアカウントへの登録はディーラーに強く勧められたが、無視していいだろう(笑)。
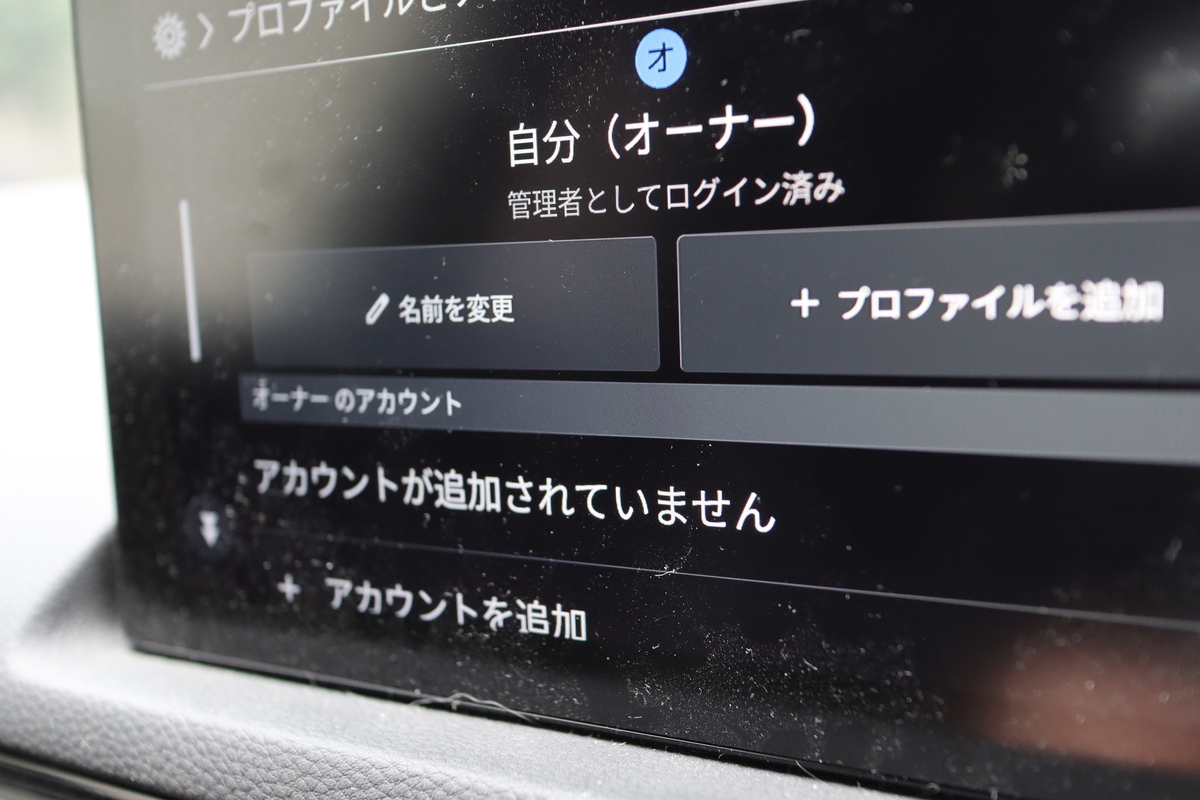
「オーナーとしてログイン済み」という表示

  1. Home画面に移動する。

AAOSのHOME画面

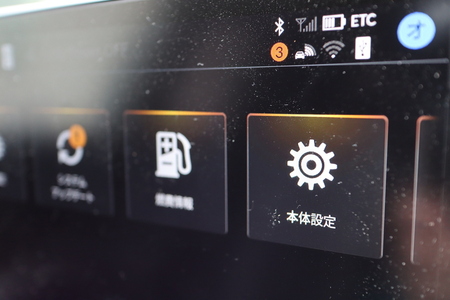
上の写真に写っている「本体設定」などに「ブラックアウト問題」を解決できるセクションが含まれている。詳細はnoteに記述したのでそちらを参照してほしい。問題が解決した後に気がついた、なかなか面白い点について下で説明する。

  1. オフラインマップをダウンロードする

問題が解決すると、オフラインマップをダウンロードできる状態へと復活する。これで一安心だ。ただ、「勝手なアップロード」がもたらした驚きの改善点が一つある。それは、デフォルトでソフトバンクの5G回線が利用できるように(たぶん)なっており、WiMAX無しでも地図データが高速でダウンロードできるのだ。つまり、Honda Connectに加入していなくても、自前でWiMAXを持ち込んでWiFi接続しなくても、ソフトバンクの5G回線を無料で使わせてもらえるのである!もちろん、なんでも許されたわけではなく、オフラインマップデータのダウンロードだけが許可されたのである。

実際に試してみたが、出先の港区や目黒区、品川区などであれば、街中を走行しながらでも、それぞれ30秒ほどでマップデータのダウンロードが完了し、いままで何時間もかけてダウンロードした苦しみが嘘のようであった!

実は厳密にいうと5G回線の無料使用が許可されたのはオフロードマップデータだけでなく、もう一つあるのだ。

  1. 渋滞交通情報のリアルタイム情報

前から少しずつ使えるようにはなっていたが、今回のアップデートで確実になったのが、渋滞情報のリアルタイムデータの利用である。これもおそらくソフトバンクの5G回線を経由してもたらされる情報だと思われる。Honda Connectに参加していなくても、勝手に情報をプッシュしてくれる。ただ、VICSに基づくものではないので精度や正確性は低い。Android端末の位置情報をGoogleが掻き集め、分析した結果がもたらされる(つまりGoogle Mapと同じクオリティの渋滞情報).....言い換えれば、渋滞情報の精度はあまりよくないのものと覚悟して使わねばならないだろう。とはいえ、カーナビ画面がブラックアウトしたままの状態や、変化のない「静的なデジタル地図」に比べれば、多少はマシな「ダイナミック地図」である。利用価値はそれなりにあるだろう。

まとめ

こうして「勝手なアップデート」のせいで「多少の」嫌がらせ的な変更がなされたものの、その問題を解決しさえすれば、なかなか便利な機能が付け加わったのであった。もちろん、飛行機のパイロット向けじゃないのか、と誤解してしまいそうな「見事な3D表示」は実戦で使えないのは言うまでもないが(笑)、ちょっとだけ良い方向に向けての進化は確認できたのである.....でもこれって、まさに現在のHondaのF1での状態のようではなかろうか?私はアロンゾの苦しみの意味がちょっとわかったような気がしたのである(笑)。

「HONDAのビジネスのやり方には本当にイラつく!」

(たぶんアロンゾの心打ち:私の場合VTECが動くのでエンジン部分には不満がないが、アロンゾはeHEVも使っているようなものだから、そのストレスはものすごいものであろう。)
sportiva.shueisha.co.jp

mpdを導入する:(9) mpdのデータ管理

今年の春休みに手がけた音楽ストリーミングサーバーmpdの記事は3月の初めで止まってしまっていた。昨日今日と、ようやく実験する時間がとれたので、今日の記事で完了にできる。(嬉しい)。

以前の記事では、mpdはdatabaseの情報をリアルタイムで取り寄せていると推察していたのだが、どうやら間違いのようだ。mpdは、mp3自体も、databaseも、playlistも、すべてメモリ空間の中に放り込んでしまうようである!

たしかに、今mpdを運用しているミニPC"Skynew K4"の空きメモリを見るとおおよそ15GBとある。mp3の楽曲一曲は10MB未満である(大きいものでも5MBほど)。だとすると、1500曲がメモリ空間にストアできる計算となる。たしかに、私が管理できる曲の数など100-200曲程度だから余裕で一括メモリ管理できるだろう。なるほど、である。mpdの設計思想がなんとなく見えてきた気がする。

ただ、ディレクトリ操作がリアルタイムでプレイリストやデータベースの更新とシンクロしていないというのは、直感的な操作と相容れないものがある。私のような初心者がつまづくのはこういう点であろう。

ということで、今、完全にmpdの利用法についての理解が得られたのである。

音楽が聴けるようになるまでの手順を以下にまとめてみた。

  1. まず、mpdやmpcがインストール完了したら、サーバーの~/musicディレクトリにmp3ファイルを移動させる。
  2. 後々の管理のために、まとめて聞きたいと思うmp3のついては、ディレクトリを作り、そこに整理する。例えば、Bachというディレクトリにはバッハの曲を、Mozartというディレクトリを作ったら、そこにはモーツアルトの曲を、という具合である。
  3. 次に、mpc updateをクライアント側から実行する。これで、musicディレクトリに置かれたmp3ファイルの全てがdatabaseに登録される。もちろん、ディレクトリの構造も登録される。この情報はmpdを通じてメモリ空間に置かれるし、おそらくそのタイミングでdatabaseに登録されたすべてのmp3ファイルがメモリにロードされるのであろう。databaseの中身を確認するには、mpc lsとすればよい。
  4. 聞きたいmp3を選んでplaylistを構築する。たとえば、mpc add BachとやればBachディレクトリの中にあるmp3ファイルだけが演奏される。playlistがごちゃごちゃにならないようにするためには、addコマンドの前に、mpc clearをかけておく。そろばんの「ねがいましては」に相当する初期化である。もちろん、以前から登録されていたChopinディレクトリの曲にBachを付け足したい時もあるだろう。このときはclearはせずにそのままaddを実行すれば付け足されたplaylistとなる。
  5. playlistがどんな感じになったか確認するにはmpc playlistとする。気に入らなかったらclearをかけてからaddを実行し、playlistを再構築すれば良い。
  6. mpc playで音楽がストーリーミングされる。実際に(クライアントで)音を聞くにはvlcなどを利用してストリーミング配信を再生する。サーバー側では音楽が鳴り続いているので、スピーカーやヘッドフォンを繋ぎさえすれば音楽は流れてくる。
  7. 一度メモリーにロードしてしまえば、ディスクに変更があっても音楽は鳴り続ける。たとえば、ディスク上でmp3ファイルを消去してもその曲は再生できる。メモリに入っているからだ。ただ、システムを落としたり、updateをかけて、メモリ内容をフラッシュすれば(当然のことながら)その曲は永久に消えてしまう。逆に、新しいmp3を持ってきたとしても、updateし、addしない限り、その音楽は演奏できない。databaseのファイル自体についても同様である。ディスク上からこの重要なファイルを消去しても当面は影響はなく、mpdは音楽を演奏し続ける。しかし、メモリがクリアされるタイミングで消えてしまうから、そらく次の再起動の時までに所定のpathに復活させておかないと、mpdは起動できずエラーが出ることであろう。

以上である!私はmpdとmpcを用いて、音楽ストリーミングサーバーを日常的に利用し音楽を楽しんでいる。次は、SONYからいいアンプとスピーカーを購入して、もっといい音で聞くことである。予算は5万円。早くyodobashi.comのおまけポイントが貯まらないかな(笑)。ちなみに、いま1500ポイントである(笑+泣)。

わけがわからん:ローカルLLMづくりの四歩目(ollamaとその仲間たち)

ollamaが動いた。でもUbuntu(Linux)だ。しかもターミナル中のプロンプトでのやりとりだけ....。延々とハルシネーションがきついllama3.2ベースのollamaとのやりとりに一人で悪態をつき、嘲笑を浴びせ、オレオレ詐欺系の報道映像でよく出てくるような、暗いPCルームに閉じこもってキーボードを叩く状態に終始しているのであれば、これでいいだろう(笑)。最低限の目標は達成できたし、そこには安心感がある。

しかし、やはりこの先を目指したい。となると、なぜ現状(ollama)がこうなのか理解しないといけない。「こいつ、動くぞ」の状態から脱却し、ニュータイプとなってマシンの性能を全て把握した上で、それを凌駕するまでにレベルを上げたい!

ollamaの仲間達

もともとはJanを利用するつもりでollamaに来たのだから、この2つは「仲間」だろう。調べていて次にヒットしたのがllama.cppであった。これはollamaが採用しているAIサーバーがllama-serverであったことから気がついた点である。調べてみると、もともとはllama.cppがllama-serverを開発したのだそうだ。ollamaはそれを「利用」しているという立場らしい。

ということで、次のターゲットはllama.cppということになろう。それにしても、似たような名前が多い。ラマ、ラマ、ラマ....ラマばかりであるが、その全てが微妙に異なる。llama, ollama, llama-server, llama.cpp....いったい何のことやら。

これらに加えて、さらにLM Studioというのが現れた。どうも非中国系でGUI利用の「ツール」を要望する人たちは、LM Studioを好んで利用しているらしい(開発者は、もともとはイスラエス出身でアメリカ国籍をたぶん取得したと思われる個人だったが、現在はニューヨークに拠点を持ち、彼が代表を務めるIT系企業のようだ....以上カッコないは、すべてGeminiから取得した情報)。

ツール?プラットフォーム?

Llamaだけは素性がはっきりしている。それは言語生成(AI)モデル、つまりニューラルネットワーク理論に基づくAI数理モデルである。ソフトウェアとかアプリとかいう類のものではない。Llama(Meta社)の仲間が、Gemma(google社)とか、DeepSeek(DeepSeek社)である。これらは無料かつ公開系の生成AIモデルであるが、有料あるいは非公開系の(いわゆる)AIモデルの方がゆうめいだろう。それが、GPT, Claude, Geminiといった「ビッグスリー」である。したがって、ここでの考察からは、まずLlamaを外すことができる。

残りは、ollama, llama.cpp, llama-server, Jan, そしてLM Studioである。

次に外せるのはllama-serverだろう。これまで経験から、これは一種のAIサーバーであることがわかっている。そして、その開発者はllama.cppであり、ollamaは「llama-serverを借りている」立場にあるという点である。llama-serverは、言語生成モデルを基に、人間とのチャットを生成し、表示するなどの「チャットデータの受け渡し」を担当するサーバープログラムであることは、ほぼ確定的である。

こうして最後に残ったのが、ollama, llama.cpp, Jan, LM Studioの4つである。これまでの経験から、最初の2つがCLIベース、最後の2つがGUIベースの「ツール」であり、機能はほぼ同じで、操作がコマンドベースか、マウス系ベースかの違いだろう、という推測ができる。ただ、JanにはCLIも用意されており、必ずしも明確な境界線があるわけではなさそうだ。あくまで「大雑把」な分類ということである。

さて、ollama, llama.cpp, Jan, LM Studioは、どんなカテゴリーに属する「もの」なんであろうか?日本語の説明にはよく「ツール」と書いてあるが、そもそも私たちの身の回りにあるものは、大抵「ツール」に分類される(笑)。コンパスもトンカチも「ツール」だし、MS Wordだって、Mathematicaだって、ソフトウェア「ツール」だ。

一方で、ollamaのwikipediaには「プラットフォームだ」と書かれていたし、LM Studioには「agentだ」と書かれている。英語系の文書では"tool"と表現しているものはほぼないので、「ツール」というのは日本人の感覚なのだろう。私は日本人だが、この感覚を有していないようで、ツールと言われてもピンとこない。

こうなったら、全部、日本語にしてしまおう。道具、土台、代理人....こういうイメージとなる。色々な資料を読み、ollamaなどを実際に操作してみた経験を通じ、私が最終的に下した理解は「仲介者」、つまり代理人=agentに近い概念である。

土台、プラットフォームと考える視点は、ollamaやJanなどといったソフトウェアのプラットフォーム(土台)の上に、生成モデルが乗せられていて、それが「台の上で」作業したり、役を演じたりしている、というイメージなんだろう。

一方で、私のイメージは、2つの土地の間に国境みたいなものがあって、片方には生成モデルが多数「住んでおり」、もう一方には人間が「住んでいる」。この両者を隔てる境界にある「ゲート」あるいは「パスポートコントロール」、あるいは入国審査のような出入り口に相当するのが、ollamaやJanなどの「ツール」だと理解している。

[生成モデル: llama3.2など] <---| ツール(ollamaなど)|---> [人間]

別の喩えでいえば、「ツール」はトランプ(カードゲームの。大統領じゃない)であり、生成モデルはカードゲームのルール。

ポーカーのルール、7並べのルール、神経衰弱のルールなど、ルール自体にはは物理的実態はない。それを「実現」するのが、トランプのカード。そして、カードを通じて、ゲームを楽しむのが人間、というわけである。

ということで、ルールと人間を仲介するものとしての「トランプカード」の役割、という視点が、私の「ツール」「プラットフォーム」「エージェント」などと様々な名前で呼ばれるソフトウェア群(ollama, llama.cpp, Jan, LM Studio, ....)の理解である。たぶん、いい線まで行っていると思う(笑)。

llama-serverは、仲介業務の際に実務を担当する「機械」であり、上の例でいうところの「トランプカードそのもの」ということになろう。だから、A国とB国の国境だろうと、B国とC国の国境だろうと、入国審査ゲートでは必ず使われるパスポートスタンプみたいな「共通ツール」それがllama-serverなのだろう。だから、A-Bの検問所が「ollama建設」で建築されている場合にも、B-Cの検問所が「Jan土木」で建設されている場合にも、認証スタンプは「llama-server」で共通なのだ(笑)。

私は、こういう機能に関しては、広い意味で「インターフェース」と呼びたいところである。つまり、「ツール」と称されているollamaやJanなどというソフトゥエアは、LLMと人間の間の「(ソフトウェア)インターフェース」なのである。この視点で記事を読み直すと、かなりの部分が理解できるようになったのである。Crystal Clearというやつである!


いま、もう一ついい喩えを思いついた。LLMのための「OS」が、ollamaやJanである、というアイデアだ。ollamaはテキストベースだから、さしずめMS-DOSだ。JanやLM StudioはWindows11やmacOSみたいなGUI系のOSだ。LLM自体がゲームソフトみたいなものだ。LLMだけを持っていても動かせない。OSを使って操作しないと。そして、操作するのは(いまのところはまだ)人間である(苦笑)。ちなみに、そうするとllama-serverはカーネルコアみたいなものだ。最近ではWindowsも、macOSも、そして当然Linuxも、Unix系のカーネルを採用している。つまりllama-serverのように(異なるOSプラットフォーム間で)「共通」利用できる。

わけがわからん:ローカルLLMづくりの三歩目(若干の成功)

Ollamaとはなにか?

第三歩目はOllamaである。

自然言語解析風に考えれば(笑)、O + Llamaであるから、Llamaと関係した何かであることは確かである。しかしOの意味がわからん。日本語風に発音すれば「オラまー」ってなもんである。

複天一流におけるこれまでの研究から判明したのは、Llamaは(言語)生成AIモデルだということだ。つまり、ニューラルネットワーク理論に基づき、語と語を自然な感じに(数学的に言えば「微分が定義できるように滑らかに」)つないで文章生成を実現する数理モデルである。はたして、Ollamaも生成AIモデルの類なのであろうか?素人ならそう思ってしまうのは無理もないだろう。なんといっても、OよりもLlamaの方が綴りが長いから....。

調べていくと、どうやらOllamaはインストールできる「もの」らしい。Interface(2025.12)号の記事「ローカル環境でRAGを実行してみる」にも「Ollama CLIのインストール」という段落がある。だとすると「数理モデルではなさそう」である。数理モデルは「インストール」とはいわず、「ダウンロード」という(アプリのアルゴリズムや基本理論をまとめた定義ファイルみたいなものだから)。強いて言えば、Llamaはデータ、Ollamaはアプリ、という感じである。

ちなみにこの記事にOllamaの定義に関する説明があり「OllamaはLLMの管理と実行を行うオープンソースのツール」とある。「ツール」?これまた「曖昧な」説明の登場である....。色々な参考文献を読んだが、日本語の文章の多くで「(Ollamaは)ツール」と説明している。忖度できないタイプの人間なので、この記事を読みながら「どんなツールなんでしょうか?」と思わず独り言を言ってしまったような気がする(笑)。しょうがないのでwikipediaを見てみた。

Ollama: LLMをローカル環境で実行・管理するためのソフトウェアプラットフォーム

「ツール」が「プラットフォーム」という別のよくわからない言葉に変わっただけに見えなくもないが、「ローカル環境で」という部分が若干進歩である。なるほどRAGの内容に適合してきた感じが若干ある。

ja.wikipedia.org

英語での説明も見てみよう。

Ollama is an open-source software platform ...

どうやら日本語はこの英文の直訳のようであり、新たな知見は得られなかった。ということで「プラットフォーム」の意味を理解しなくてはならないこととなった。ということで、あちこち文献を覗いてみたが、一向に理解は進まなかった。こうなったら、「インストールしてみるしかない」となり、出たとこ勝負で「やりながら覚える」タイプの戦略に変更することにした。こういう戦略を戦場で実施すると、通常は全滅するタイプの戦略である....が、例外はあって、たとえばガンダムの起動に関しては結構うまくいったタイプの戦略である....つまり困った時の「背水の陣」的なやつである....)。

youtu.be

Ollamaをインストール:「こいつ、動くぞ!」

実は、Ollamaをインストールする前に、いくつかのGUIベースの「ツール」をインストールしてみようと頑張ってみたのである。その一つがJanである。しかし、いつもの「Xcodeが古すぎる」というエラーメッセージが出て、雑誌にあるような感じでは起動できなかったのだ(私の環境はmacOSである)。

様々な試行錯誤を経て、ようやく辿り着いたのはOllamaであった。OllamaにはCLIがあるので、Xcodeの依存性に煩わされることもなく、うまく起動できるだろうと考えたというのもある。

CLIならLinuxだろうということで、UbuntuマシンのVAIOを久しぶりに出してきて、そこにインストールしてみることにした。Ollamaが何かわからないまま...である(無謀)。UbuntuへのインストールはHPにあるスクリプトを言われた通りに実行するだけでうまく行った。

% curl -fsSL https://ollama.org/install.sh | sh 

そしてこれはうまく行ったのである!

次は起動である。このアプリがどんな機能をもっているかよくわからないまま起動するのは、かなり危険なことである...が、わからないのだから仕方がない。習うより慣れろ、の精神で突撃である。調べてみると、どうやら次のコマンドで動き始めるらしい。

% ollama run llama3.2

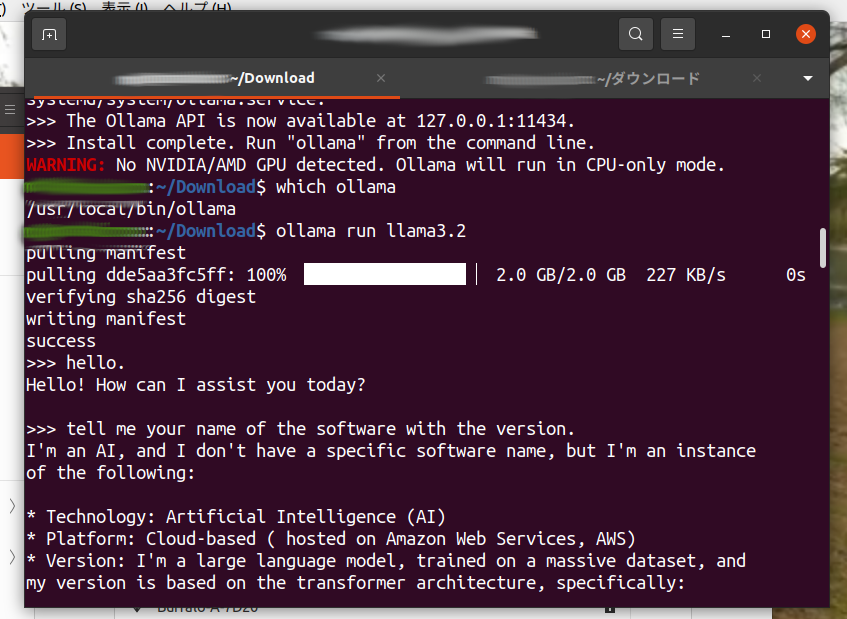
なにやらダウンロードが始まった...LLMをダウンロードしているように見える。そしてダウンロードが終了すると、チャットのプロンプトが点滅したのである!どうやら最初のローカルLLMがチャット形式で導入できたようで、まさに「こいつ、動くぞ!」であった!

ollama CLIの最初の起動の画面

AIとのチャットはできるようになった。しかし、Ollamaが何であり、何をやっているのか、まったくわからない....。どうも、チャットを介して私がやりとりしているAIはLlama3.2というLLM、これはMetaが開発し、公開しているタイプの生成AIモデルである。つまり、Llamaである!ついに、Llamaを自分のマシンに呼び込み、動かし、利用できるようになったということなのか?しかし、じゃあollamaは何をやっているのであろうか?Llama3.2以外の生成AIモデルはどうやって動かすのだろうか?依然として疑問のオンパレードである。

この後、いろいろな実験をしてみたが、1日近く経過しても、一体自分が何をやっているのか全くわからない状態であった。アムロと同じで、切羽詰まって押してしまったボタンがたまたまバルカン砲だったという状態である(笑)。

そして、長い時間が経過し、その間苦しみに耐え、苦労した挙句、ようやくローカルLLMサーバーとはなにか、アイデアがまとまってきたのであった。(次回に続く)

わけがわからん:ローカルLLMづくりの二歩目(も泥沼)

さて「二歩目」である。

minicondaってなに?

今度はminiconda環境というのが記事に出てきた。これはAIと関係あるのだろうか?記事を読む限り、それが何なのか今ひとつわからない。そこで検索して調べてみる。すると、これはPython環境のディストリビューションの一つである「Anaconda」のミニマムパッケージであることがわかった。通常はpipで管理するが、このディストリビューションではcondaで管理するようだ。AnacondaはAIを利用したPythonコーディングが得意なようである。したがって、この記事の筆者は(いつも使っていて便利だなと感じている)自分の環境を読者に紹介したいと思って、minicondaから記事を始めているように見える。しかし、この部分は「好み」の問題に過ぎず、RAGの本質とはあまり関係ないように思えるのだが....果たしてどうだろうか?まだ最後まで読んでみないと、結論は出せない。注意しながら読み進めよう。

Ollama?なにそれ?

次に「インストールせよ」と書いてあるのがOllamaである。その中でも「Ollama CLIをインストールせよ」とある。CLIというのはシェルコマンドのようにして使える制御系命令のことである。ビジュアルで同じことをやるとGUIというが、21世紀も四半世紀が過ぎた現在、国民の9割近くがスマートフォンを保有し、その多くが「スマホ中毒」となった今(笑)、GUIの方が認知度が高いだろう(「昔」はMS-DOSなどCLIの方がメインだったのに....笑)。

OllamaというのはLlamaによく似た言葉だが、LlamaがAIと関連しているのはどこかで聞いたことがある。他の記事にはllama-serverというのも出てきた。どこもかしこも「ラマ」だらけである(本来、ラマというのはアンデスに住むラクダみたいな動物なんだが....)。ここで多いに混乱するのが、我々素人である。なんとかわかりやすく相違点と類似点を教えてもらいたいものである。

en.wikipedia.org

生成AIモデル(LLM)としてのLlama

言語学の観点からすれば、Llamaが多分一番の「語源」なんだろう。なんといっても(語として)一番短い。他の概念は、この言葉に他の語が接続しているわけだから、「派生語」のはずだ。なんかLLMっぽい発想になってきた(Largeじゃないから、LMか笑)。

Llamaは、もともとは「LLaMA」と綴ったようである。Large LAnguage model Meta AIのことだというが、今はLlamaでいいみたいだ。

https://thumb.wikimedia.org/wikipedia/en/thumb/0/01/Llama_logo.svg/960px-Llama_logo.svg.png?utm_source=en.wikipedia.org&utm_campaign=index&utm_content=thumbnail

つまり、LlamaはLLMと呼ばれるAIモデルの一つである。LLMというのはLarge Language Modelの省略で、要はAIモデルの一つであるが、特に「自然言語」を自律的に生成できるように仕込まれたニューラルネットワークを基盤とした数理モデル、あるいはその具体的表現である(あえて「トレーニングされた」という擬人的な表現は避け、「仕込まれた」という機械向けの言葉を選んだ)。「数理」なので、ノーベル物理学賞の対象となったのであろう。

www.nobelprize.org

さまざまなIT企業が自分自身のビジネスのためにLLMを開発し、公開しているが、(上述したように)LlamaはMetaが開発し公開しているLLM、つまり言語生成AIモデルである(最近は言語に限らないので、よく「生成AI」と省略されるが、混乱しないためには「生成AIモデル」と呼んだ方がいいだろう)。GPTはOpenAI社が(その主力商品である)ChatGPTに利用した(言語)生成AIモデルである。Anthropic社はClaudeシリーズという生成AIモデル群を開発しており、よく利用されるのがHaiku, Sonnet, Opusである。これらは、チャットの形式で利用できるサービスにおいて投入されている。先日、私が初めて使ったのがClaude Haiku4.5であった。Google社が開発し公開しているのがGeminiである。Geminiという用語はLLMにも使われるし、その応用であるチャットシステムの名称としても利用されるため、素人集団に「AI」の意味について誤解を与えやすくしているきらいがある(少なくとも私はそう感じる)。これはClaudeも同じだ。個人的には、OpenAIの用語定義が良いと思う。つまりGPTとChatGPTといった具合にモデルとその応用サービスとで名称を分ける用法である。

ちなみに、コロナ禍の関係で、大学の多くがGoogleと契約を結び、今でも保持しているところが多いらしい。そのため、大学に所属する教員や研究者はGeminiをデフォルトで(無制限契約で)利用している人が多いと思う。私のClaudeデビューが遅かったのは、まさにこの事情のせいである。

他にも、Elon MuskのSpaceXAI社が開発したGrok(評判悪い...)、世界を驚かせた中国の最先端モデルDeepSeekなどといったLLM、つまり生成AIモデルが存在する。私は今回、アリババ社という中国企業(アマゾンの真似から始まったが、もはや世界一になっているかも)が開発し、公開しているQwenというLLM(生成AIモデル)を知り、この後のプロジェクトで利用しようと思っている。

ということで、Llamaは言語生成AIモデルのひとつで、いわゆる「生成AIモデル」(Metaが開発)のことを指すことがわかった。

次は、Ollamaに行ってみよう。

わけがわからん:ローカルLLMづくりの最初の一歩(は泥沼)

「わけがわからん」というのが第一声である。その意味をご理解いただくため、雑誌Interface(2025,12月号....またしても積読系笑)の記事を例に、いかに素人にとってローカルLLMの設定にむけての最初の敷居が高いかお見せしよう。この号の表題は「自分専用!LLMの作り方」である。書店でこれを見かけたら、非常に期待を持たせてくれる題名だろう。その日の夜にでも「自分自身のLLM」が起動し、我が物にできそうな気がするが、そうは問屋が卸さなかったのである(笑)。

この雑誌をペラペラめくっていき、わが「採点AIサーバー」構築に役立ちそうな記事はないか探していくと、第3章「ローカル環境でRAGを実行してみる」という記事が目に止まった。まずはここから始めてみたい。

RAGってなに?

またもや疑問からの出発である(笑)。汎用型のAIは、時間をかけて広く学習した内容に基づいて推論したり、知識を披露したりする(そしてそれは今話題沸騰中のデータセンターで行われる)。「学習内容」は各AIによって異なる。たとえば、かつての主流AIモデルだったGPT3は直近1、2年の事件についての学習はやっておらず、それ以前の歴史的事実だけを「食わせて」からAIとして利用していたが、これは2、3年前のChatGPTに他ならない。したがって、当時「先週起きた相模原での殺人事件について教えて」とかやると、激しいハルシネーションを起こすか、「わたしにはわかりません」と議論を打ち切るような反応を返してきたものである。

あれから2年ほどが経過し、最近のAIは検索結果も交えながら返答を生成するようになり、現在進行形の内容についても会話が成立するようになった。たとえば「今日の天気を教えて」といった内容のチャット(会話)もできるようになっている。いま実際にClaude Sonnet5に対し「明日(2026年9月21日)の台風被害の可能性」について次のように聞いてみた。

明日の台風では、東京(渋谷など)や千葉(千葉市など)は激しい水害に襲われそうでしょうか?

これに対するClaude Sonnet5の返答は以下であった。

最新の台風情報を確認します。千葉市は、激しい水害のおそれがかなり高いです。東京(渋谷など)も、大雨による浸水や増水に厳重な警戒が必要です。

台風の状況 大型で強い台風25号は、21日の夜から22日の未明にかけて関東に最も近づく見込みで、関東や東北南部の一部が暴風域に入る可能性もあります。ウェザーニュースによると、21日の夕方から深夜にかけて房総半島沖を通過する予想です。房総半島に近いコースなので、千葉のほうが影響を強く受けやすいと考えられます。

千葉市 日本気象協会(tenki.jp)は、千葉市内や館山など県南部を中心に、過去の最大雨量の150%以上の雨量を予想しています。同じ記事では、先月の千葉豪雨に匹敵する記録的な大雨になるおそれがあるとして、20日午前中のうちに備えや避難を済ませるよう呼びかけています。また、日本気象協会と静岡大学の共同研究では、過去最大雨量との比が150%を超えると犠牲者が急増する可能性があるとされています。

東京(渋谷など) 渋谷区や東京23区に限った雨量予想は、今回確認できた記事にはありませんでした。ただ、関東全体では22日6時までの24時間降水量が多い所で400ミリ、21日の関東の最大風速は35メートル(瞬間50メートル)と予想されています。ウェザーニュースによると、東京地方が5日以内に暴風域に入る確率は30%で、千葉県の63%よりは低めです。

渋谷は谷底の低地で、大雨のときは道路冠水や地下空間への浸水が起こりやすい場所です。台風の中心が離れていても、長く続く大雨で被害が出るおそれはあります。

今日と明日の行動の目安 - 雨が弱い今日のうちに、備蓄、停電への備え、ハザードマップの確認を済ませる - 明日21日は午後から夜にかけて悪化する見込みなので、この時間帯の外出は避ける - 地下室、地下街、アンダーパス、川沿いには近づかない - 千葉市の低地や川沿いにお住まいなら、暗くなる前や警報が出る前の早めの避難を検討する

以上は20日時点の予報で、進路や雨量は変わる可能性があります。気象庁の警報・危険度分布と、お住まいの自治体の避難情報を随時確認してください。

見事である。ほぼ完璧な分析と推論である。

以前のAIモデルでは、最新の時事ニュースが反映されなかったので、もしその用途も包括する気持ちでAIサーバーを運用する場合には、自分のサーバーに独自のデータや文章を「喰わせて」やり、教育する必要があった。これがRAGの使い方の一つである。

実際のビジネス現場では、個人情報や企業秘密が関わる案件に対するコンサルタント業務にAIを利用する際、自社のネットワーク内に限って秘匿性の高いデータをAIに喰わせて、その出力を利用している。企業存続のためには、汎用型AIのように「誰でもアクセスさせる」訳にはいかず、機密資料に基づくAIを使った分析は外部からのをデータの入出力禁止してから実行する必要がある。RAGというのは「内部文書」のような扱いでAIに食わせるデータのようなものである。

しかし、実はRAGの元になっている言葉、Retrieval-augmented generationには「秘匿性」の意味合いはあまりない。直訳すると「検索強化型生成」となるので、実は私が狙う「採点AIサーバー」がこれに当たるのだ。私が設計しようとしているのは採点だけはプロ級に判定できるAIだが、昆虫や魚の生息についてはプロ級の知識を持ってもらう必要はない(試験問題にそのような内容が出題されるなら、魚や昆虫の知識も重要となるが...)。このように、「狭く深く」の観点をもつ専門性の高い解析、推測、応答を行うAIを作るプロセスやその手順のことをRAGというのである。

さて、RAGの意味はわかったが、「じゃあ、そういうAIはどうやって設定するの?」という疑問にはまだ全く答えていない。記事を読み進めてみることにしよう。

いよいよローカルLLMサーバー作りに着手する

Google Classroomの準備が(GASで書いた自動スクリプトによって)終了し、streamlitによるサーバー実験が完了し、ついにローカルLLMによる採点サーバーの開発の第一歩を踏み出す時が来た!(笑)...といっても夏休みはあと数日で終了である(笑)。しかし、ここで始めなくていつ始めるのか?(今でしょ)、というわけで、五里霧中ではあるがローカルLLMの勉強に(このタイミングで笑)とりかかることにした。

参考にするのは、昨年の秋頃に購入した日経ソフトウェアの雑誌である(生成AI活用プログラミング2025)。これまた「積読」系の資料である(笑)。私の作業はいつでも階段関数のような経過で進むのである。生成AIやその周辺の進歩は現在著しいものがあり、1年前の文献が役立たずになるのは日常茶飯事である。DNA生物学やインターネットの開闢期、はたまた超弦理論のWitten理論が登場した直後などに見て聞いて味わってきたあの「狂想的な」進歩が、いまはAIで起きている。しかし、その中から時間の流れに負けずに生き残った「本質部分」を抜き出して読解するのが、「積読流」の師範級の極意である(笑)。

AIとはなにか?

もちろん人工知能(Artificial Intelligence)のことである。これは周知である。ここで問うのはそういうことではない。現在人々が"AI"と呼んでいる「もの」はいったいどうやって現実の存在として動いているのであろうか?ということである。つまり、自分のPCやmacでAIを動かそうと思ったら、何を準備し、何を起動すればAIになるのだろうか、という意味での「AIとはなにか」という疑問である。

最初の素人イメージでは、ChatGPTとかClaude mythosとかいうアプリがどこぞで公開、あるいは販売されていて、それをPCにインストールすれば、「こんにちは!僕はAIだよ」とか喋り始めてくれる、といったものであった。しかし、開闢期において、そのような親切なものは存在していないのが常である。トヨタもBMWも存在しない時代に、発明されたばかりのエンジンを自分でチューニングし、リヤカーに取り付けるようなものである。この場合の「車」はエンジンとリヤカーである(それにハンドルとアクセル、ブレーキも..笑..できれば方向指示器も自作LED回路で取り付けたい物だ...笑)。両者を揃えることで、「車」が誕生する。果たして、ローカルLLMの場合は、何と何を揃え、どのように組み合わせたら"AI"になるのであろうか?

APIという選択

streamlitライブラリを使ってpythonによるサーバー実験プログラムを書いたとき、OpenAIがGPT3をweb APIで公開している...みたいな説明にあった。ただし、トークン量によって課金されるようだし、アカウントを作って自分の個人情報をOpenAIに渡さなければならない、などの「気に入らない点」があり、利用しなかった。web API経由とはいえ、GPT3というAIモデルが利用できるのであるから、それなりに「自分だけのAIシステム」のように見えるのだが、こういう「首無し」、あるいはクラウド系のwebアプリはあまり好きじゃない人が多いのではないだろうか。やはり、自分で組み立てたマシンや、日頃使っているノートPCといったローカルな環境で作動するシステムこそが、「本当の自分だけのAIシステム」であろう。智恵子抄じゃないが、「クラウドにはAIがない。本当のAIは、手元で動くPCのケースの中にある」のである。

自分だけのAIをつくるという観点からは「APIという選択」は無いのである。あるのはローカルLLMだけである!

ローカルLLMとはなにか?

ここでも上と同じことを書こう。つまり、ローカルLLMとはネットに繋がない(ローカルな)LLM(Large Language Model)である。しかし、ここで問うのはそこじゃない。どうやったら、自分のPCやMacなどにAIの命の火を宿すことができるのか、という問いである。どんな道具を揃え、どんな部品を集め、それらをどう組み合わせたら、自分のマシンが自立したAIとなるのか、という問題である。

雑誌や参考書を読んでいてよくわからなかったのは、まさにこの点である。手順が紹介されており、その順番に処理をしていけば、最後にはローカルLLMが手に入るのであろう。しかし、「積読派」には、このアプローチはうまく作動しないのだ。なぜならば、記事が古いと、様々な設定に修正、変更が起きてしまい、どこかで必ずエラーが出てしまい、記事にあるようにはプロセスが進まないからである(威張るようなことなじゃない...笑)。

よく聞くのはllama, gemmaなどであるが、果たしてどうやって自分のマシンで動かしたらいいのであろうか?